

Swift 4 में Swift का Codable API लॉन्च किया गया था. इसकी मदद से, कंपाइलर की क्षमता का इस्तेमाल करके, सीरियलाइज़ किए गए फ़ॉर्मैट से Swift टाइप में डेटा को आसानी से मैप किया जा सकता है.
ऐसा हो सकता है कि आपने Codable का इस्तेमाल, वेब एपीआई से मिले डेटा को अपने ऐप्लिकेशन के डेटा मॉडल में मैप करने के लिए किया हो. इसके अलावा, इसका इस्तेमाल ऐप्लिकेशन के डेटा मॉडल से मिले डेटा को वेब एपीआई में मैप करने के लिए भी किया जा सकता है. हालांकि, यह इससे कहीं ज़्यादा फ़ायदेमंद है.
इस गाइड में, हम देखेंगे कि Codable का इस्तेमाल करके, Cloud Firestore से Swift टाइप और Swift टाइप से में डेटा को कैसे मैप किया जा सकता है.
Cloud Firestore से कोई दस्तावेज़ फ़ेच करते समय, आपके ऐप्लिकेशन को कुंजी/वैल्यू पेयर की डिक्शनरी मिलेगी. इसके अलावा, अगर एक से ज़्यादा दस्तावेज़ दिखाने वाले किसी ऑपरेशन का इस्तेमाल किया जाता है, तो डिक्शनरी का कलेक्शन मिलेगा.
अब Swift में डिक्शनरी का सीधे तौर पर इस्तेमाल जारी रखा जा सकता है. साथ ही, ये डिक्शनरी कुछ बेहतरीन सुविधाएं देती हैं, जो आपके इस्तेमाल के उदाहरण के लिए ज़रूरी हो सकती हैं. हालांकि, यह तरीका टाइप सेफ़ नहीं है. साथ ही, एट्रिब्यूट के नामों की गलत स्पेलिंग लिखने या नए एट्रिब्यूट को मैप करना भूल जाने से, ऐसे बग आ सकते हैं जिनका पता लगाना मुश्किल होता है. ऐसा तब हो सकता है, जब आपकी टीम ने पिछले हफ़्ते कोई नई सुविधा लॉन्च की हो और उसमें नया एट्रिब्यूट जोड़ा हो.
पहले, कई डेवलपर ने इन कमियों को दूर करने के लिए, एक आसान मैपिंग लेयर लागू की थी. इससे उन्हें डिक्शनरी को Swift टाइप से मैप करने में मदद मिली. हालांकि, इनमें से ज़्यादातर तरीके, Cloud Firestore दस्तावेज़ों और आपके ऐप्लिकेशन के डेटा मॉडल के टाइप के बीच, मैन्युअल तरीके से मैपिंग तय करने पर आधारित होते हैं.
Swift के Codable API के लिए Cloud Firestore की सहायता से, यह काम काफ़ी आसान हो जाता है:
- अब आपको किसी भी मैपिंग कोड को मैन्युअल तरीके से लागू करने की ज़रूरत नहीं होगी.
- अलग-अलग नामों वाले एट्रिब्यूट को मैप करने का तरीका तय करना आसान है.
- इसमें Swift के कई टाइप के लिए पहले से सहायता मौजूद है.
- साथ ही, कस्टम टाइप को मैप करने के लिए सहायता जोड़ना आसान है.
- सबसे अच्छी बात यह है कि आसान डेटा मॉडल के लिए, आपको कोई मैपिंग कोड लिखने की ज़रूरत नहीं होगी.
डेटा मैप करना
Cloud Firestore, डेटा को दस्तावेज़ों में सेव करता है. ये दस्तावेज़, कुंजियों को वैल्यू से मैप करते हैं. किसी दस्तावेज़ से डेटा फ़ेच करने के लिए, हम DocumentSnapshot.data() को कॉल कर सकते हैं. इससे फ़ील्ड के नामों को Any से मैप करने वाली डिक्शनरी मिलती है: func data() -> [String : Any]?.
इसका मतलब है कि हम हर फ़ील्ड को ऐक्सेस करने के लिए, Swift के सबस्क्रिप्ट सिंटैक्स का इस्तेमाल कर सकते हैं.
import FirebaseFirestore

#warning("DO NOT MAP YOUR DOCUMENTS MANUALLY. USE CODABLE INSTEAD.")
func fetchBook(documentId: String) {
  let docRef = db.collection("books").document(documentId)

  docRef.getDocument { document, error in
    if let error = error as NSError? {
      self.errorMessage = "Error getting document: \(error.localizedDescription)"
    }
    else {
      if let document = document {
        let id = document.documentID
        let data = document.data()
        let title = data?["title"] as? String ?? ""
        let numberOfPages = data?["numberOfPages"] as? Int ?? 0
        let author = data?["author"] as? String ?? ""
        self.book = Book(id:id, title: title, numberOfPages: numberOfPages, author: author)
      }
    }
  }
}
हालांकि, यह कोड आसान और लागू करने में आसान लग सकता है, लेकिन यह नाज़ुक है, इसे मैनेज करना मुश्किल है, और इसमें गड़बड़ी होने की संभावना ज़्यादा है.
जैसा कि आप देख सकते हैं, हम दस्तावेज़ के फ़ील्ड के डेटा टाइप के बारे में अनुमान लगा रहे हैं. ये सही भी हो सकते हैं और नहीं भी.
ध्यान रहे, कोई स्कीमा न होने की वजह से, कलेक्शन में आसानी से नया दस्तावेज़ जोड़ा जा सकता है. साथ ही, किसी फ़ील्ड के लिए अलग टाइप चुना जा सकता है. ऐसा हो सकता है कि आप गलती से numberOfPages फ़ील्ड के लिए स्ट्रिंग चुन लें. इससे मैपिंग की ऐसी समस्या हो सकती है जिसका पता लगाना मुश्किल हो. साथ ही, जब भी कोई नया फ़ील्ड जोड़ा जाएगा, तब आपको अपना मैपिंग कोड अपडेट करना होगा. यह काफ़ी मुश्किल काम है.
साथ ही, यह भी ध्यान रखें कि हम Swift के स्ट्रॉन्ग टाइप सिस्टम का फ़ायदा नहीं ले रहे हैं. यह सिस्टम, Book की हर प्रॉपर्टी के लिए सही टाइप को सटीक तरीके से जानता है.
Codable क्या है?
Apple के दस्तावेज़ के मुताबिक, Codable "एक ऐसा टाइप है जो खुद को बाहरी रिप्रज़ेंटेशन में और उससे बाहर बदल सकता है." असल में, Codable, Encodable और Decodable प्रोटोकॉल के लिए एक टाइप एलियस है. Swift टाइप को इस प्रोटोकॉल के मुताबिक बनाने पर, कंपाइलर इस टाइप के इंस्टेंस को JSON जैसे सीरियलाइज़ किए गए फ़ॉर्मैट से कोड/डीकोड करने के लिए ज़रूरी कोड को सिंथेसाइज़ करेगा.
किसी किताब के बारे में डेटा स्टोर करने के लिए, एक आसान टाइप कुछ ऐसा दिख सकता है:
struct Book: Codable {
  var title: String
  var numberOfPages: Int
  var author: String
}
जैसा कि आपने देखा, टाइप को Codable के मुताबिक बनाने के लिए, कोड में बहुत कम बदलाव करने पड़े. हमें सिर्फ़ प्रोटोकॉल के मुताबिक बदलाव करने थे. इसके अलावा, कोई और बदलाव करने की ज़रूरत नहीं थी.
इसकी मदद से, अब हम किसी किताब को JSON ऑब्जेक्ट में आसानी से कोड में बदल सकते हैं:
do {
  let book = Book(title: "The Hitchhiker's Guide to the Galaxy",
                  numberOfPages: 816,
                  author: "Douglas Adams")
  let encoder = JSONEncoder()
  let data = try encoder.encode(book)
}
catch {
  print("Error when trying to encode book: \(error)")
}
किसी JSON ऑब्जेक्ट को Book इंस्टेंस में डिकोड करने का तरीका इस तरह है:
let decoder = JSONDecoder()
let data = /* fetch data from the network */
let decodedBook = try decoder.decode(Book.self, from: data)
Codable का इस्तेमाल करके, Cloud Firestore दस्तावेज़ों में सामान्य टाइप के डेटा को मैप करना
Cloud Firestore में कई तरह के डेटा टाइप इस्तेमाल किए जा सकते हैं. इनमें सामान्य स्ट्रिंग से लेकर नेस्ट किए गए मैप तक शामिल हैं. इनमें से ज़्यादातर, Swift के पहले से मौजूद टाइप से सीधे तौर पर मेल खाते हैं. ज़्यादा मुश्किल डेटा टाइप को मैप करने से पहले, आइए कुछ आसान डेटा टाइप को मैप करने का तरीका देखें.
Cloud Firestore दस्तावेज़ों को Swift टाइप के साथ मैप करने के लिए, यह तरीका अपनाएं:
- पक्का करें कि आपने अपने प्रोजेक्ट में
FirebaseFirestoreफ़्रेमवर्क जोड़ा हो. ऐसा करने के लिए, Swift Package Manager या CocoaPods का इस्तेमाल किया जा सकता है. - अपनी Swift फ़ाइल में
FirebaseFirestoreइंपोर्ट करें. - अपने टाइप को
Codableके मुताबिक बनाएं. - (ज़रूरी नहीं, अगर आपको
Listव्यू में टाइप का इस्तेमाल करना है) अपने टाइप मेंidप्रॉपर्टी जोड़ें. साथ ही,@DocumentIDका इस्तेमाल करके Cloud Firestore को बताएं कि इसे दस्तावेज़ आईडी से मैप करना है. हम इस बारे में आगे और बात करेंगे. - दस्तावेज़ के रेफ़रंस को Swift टाइप से मैप करने के लिए,
documentReference.data(as: )का इस्तेमाल करें. - Swift टाइप के डेटा को Cloud Firestore दस्तावेज़ में मैप करने के लिए,
documentReference.setData(from: )का इस्तेमाल करें. - (ज़रूरी नहीं है, लेकिन हमारा सुझाव है कि आप इसे इस्तेमाल करें) गड़बड़ी को ठीक करने का सही तरीका लागू करें.
आइए, इसके हिसाब से Book टाइप को अपडेट करें:
struct Book: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
}
इस टाइप को पहले से ही कोड किया जा सकता था. इसलिए, हमें सिर्फ़ id प्रॉपर्टी जोड़नी थी और उसे @DocumentID प्रॉपर्टी रैपर के साथ एनोटेट करना था.
दस्तावेज़ को फ़ेच और मैप करने के लिए, पिछले कोड स्निपेट का इस्तेमाल करके, हम सभी मैन्युअल मैपिंग कोड को एक लाइन से बदल सकते हैं:
func fetchBook(documentId: String) {
  let docRef = db.collection("books").document(documentId)

  docRef.getDocument { document, error in
    if let error = error as NSError? {
      self.errorMessage = "Error getting document: \(error.localizedDescription)"
    }
    else {
      if let document = document {
        do {
          self.book = try document.data(as: Book.self)
        }
        catch {
          print(error)
        }
      }
    }
  }
}
getDocument(as:) को कॉल करते समय, दस्तावेज़ का टाइप बताकर इसे और भी कम शब्दों में लिखा जा सकता है. यह आपके लिए मैपिंग करेगा और मैप किए गए दस्तावेज़ वाला Result टाइप दिखाएगा. इसके अलावा, डिकोड न हो पाने पर गड़बड़ी का मैसेज दिखाएगा:
private func fetchBook(documentId: String) {
  let docRef = db.collection("books").document(documentId)

  docRef.getDocument(as: Book.self) { result in
    switch result {
    case .success(let book):
      // A Book value was successfully initialized from the DocumentSnapshot.
      self.book = book
      self.errorMessage = nil
    case .failure(let error):
      // A Book value could not be initialized from the DocumentSnapshot.
      self.errorMessage = "Error decoding document: \(error.localizedDescription)"
    }
  }
}
किसी मौजूदा दस्तावेज़ को अपडेट करना, documentReference.setData(from: ) को कॉल करने जितना आसान है. गड़बड़ी को ठीक करने के कुछ बुनियादी तरीकों के साथ, यहां Book इंस्टेंस को सेव करने का कोड दिया गया है:
func updateBook(book: Book) {
  if let id = book.id {
    let docRef = db.collection("books").document(id)
    do {
      try docRef.setData(from: book)
    }
    catch {
      print(error)
    }
  }
}
नया दस्तावेज़ जोड़ते समय, Cloud Firestore दस्तावेज़ को नया दस्तावेज़ आईडी अपने-आप असाइन कर देगा. यह सुविधा तब भी काम करती है, जब ऐप्लिकेशन ऑफ़लाइन हो.
func addBook(book: Book) {
  let collectionRef = db.collection("books")
  do {
    let newDocReference = try collectionRef.addDocument(from: self.book)
    print("Book stored with new document reference: \(newDocReference)")
  }
  catch {
    print(error)
  }
}
सिंपल डेटा टाइप को मैप करने के अलावा, Cloud Firestore कई अन्य डेटा टाइप के साथ काम करता है. इनमें से कुछ स्ट्रक्चर्ड टाइप हैं. इनका इस्तेमाल करके, किसी दस्तावेज़ में नेस्ट किए गए ऑब्जेक्ट बनाए जा सकते हैं.
नेस्ट किए गए कस्टम टाइप
हम अपने दस्तावेज़ों में जिन एट्रिब्यूट को मैप करना चाहते हैं उनमें से ज़्यादातर एट्रिब्यूट की वैल्यू आसान होती हैं. जैसे, किताब का टाइटल या लेखक का नाम. लेकिन उन मामलों के बारे में क्या जब हमें ज़्यादा जटिल ऑब्जेक्ट को स्टोर करना हो? उदाहरण के लिए, हो सकता है कि हम किताब के कवर के यूआरएल को अलग-अलग रिज़ॉल्यूशन में सेव करना चाहें.
Cloud Firestore में ऐसा करने का सबसे आसान तरीका है, मैप का इस्तेमाल करना:

इससे जुड़ा Swift स्ट्रक्चर लिखते समय, हम इस बात का फ़ायदा ले सकते हैं कि Cloud Firestore, यूआरएल के साथ काम करता है. यूआरएल वाले फ़ील्ड को सेव करते समय, उसे स्ट्रिंग में बदल दिया जाएगा. इसके उलट, स्ट्रिंग को यूआरएल में बदल दिया जाएगा:
struct CoverImages: Codable {
  var small: URL
  var medium: URL
  var large: URL
}

struct BookWithCoverImages: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var cover: CoverImages?
}
ध्यान दें कि हमने Cloud Firestore दस्तावेज़ में कवर मैप के लिए, CoverImages स्ट्रक्चर को कैसे तय किया है. BookWithCoverImages पर कवर प्रॉपर्टी को वैकल्पिक के तौर पर मार्क करके, हम इस बात को मैनेज कर सकते हैं कि कुछ दस्तावेज़ों में कवर एट्रिब्यूट शामिल न हो.
अगर आपको यह जानना है कि डेटा फ़ेच करने या अपडेट करने के लिए कोई कोड स्निपेट क्यों नहीं है, तो आपको यह जानकर खुशी होगी कि Cloud Firestore से डेटा पढ़ने या उसमें डेटा लिखने के लिए, कोड में बदलाव करने की ज़रूरत नहीं है: यह सब उस कोड के साथ काम करता है जो हमने शुरुआती सेक्शन में लिखा है.
ऐरे
कभी-कभी, हमें किसी दस्तावेज़ में वैल्यू का कलेक्शन सेव करना होता है. किसी किताब की शैलियां इसका एक अच्छा उदाहरण हैं: द हिचहाइकर्स गाइड टू द गैलेक्सी जैसी किताब कई कैटगरी में आ सकती है — इस मामले में "साइंस फ़िक्शन" और "कॉमेडी":

Cloud Firestore में, हम वैल्यू के कलेक्शन का इस्तेमाल करके इसे मॉडल कर सकते हैं. यह किसी भी कोडेबल टाइप के लिए काम करता है, जैसे कि String, Int वगैरह. यहां बताया गया है कि हमारे Book मॉडल में, शैलियों की कैटगरी कैसे जोड़ी जा सकती है:
public struct BookWithGenre: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var genres: [String]
}
यह किसी भी कोडेबल टाइप के लिए काम करता है. इसलिए, हम कस्टम टाइप का भी इस्तेमाल कर सकते हैं. मान लें कि हमें हर किताब के लिए टैग की एक सूची सेव करनी है. टैग के नाम के साथ-साथ, हम टैग का रंग भी सेव करना चाहते हैं. जैसे:
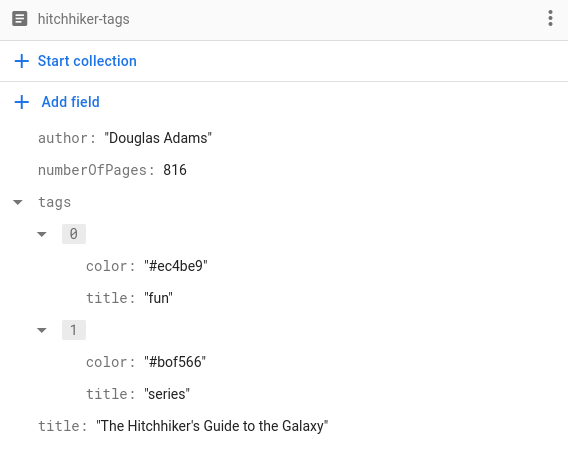
टैग को इस तरह से स्टोर करने के लिए, हमें सिर्फ़ एक Tag स्ट्रक्चर लागू करना होगा, ताकि टैग को दिखाया जा सके और उसे कोड किया जा सके:
struct Tag: Codable, Hashable {
  var title: String
  var color: String
}
इसी तरह, हम अपने Book दस्तावेज़ों में Tags का ऐरे सेव कर सकते हैं!
struct BookWithTags: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var tags: [Tag]
}
दस्तावेज़ के आईडी मैप करने के बारे में खास जानकारी
ज़्यादा टाइप को मैप करने से पहले, आइए कुछ देर के लिए दस्तावेज़ आईडी को मैप करने के बारे में बात करते हैं.
हमने पिछले कुछ उदाहरणों में @DocumentID प्रॉपर्टी रैपर का इस्तेमाल किया है, ताकि हम अपने Cloud Firestore दस्तावेज़ों के दस्तावेज़ आईडी को Swift टाइप की id प्रॉपर्टी से मैप कर सकें. ऐसा करना कई वजहों से ज़रूरी है:
- इससे हमें यह जानने में मदद मिलती है कि अगर उपयोगकर्ता स्थानीय तौर पर बदलाव करता है, तो किस दस्तावेज़ को अपडेट करना है.
- SwiftUI के
Listके लिए ज़रूरी है कि इसके एलिमेंटIdentifiableहों, ताकि एलिमेंट को शामिल करते समय वे इधर-उधर न हों.
यह बताना ज़रूरी है कि दस्तावेज़ को वापस लिखते समय, @DocumentID के तौर पर मार्क किए गए एट्रिब्यूट को Cloud Firestore के एन्कोडर से एन्कोड नहीं किया जाएगा. ऐसा इसलिए है, क्योंकि दस्तावेज़ आईडी, दस्तावेज़ का एट्रिब्यूट नहीं होता. इसलिए, इसे दस्तावेज़ में लिखना एक गड़बड़ी होगी.
नेस्ट किए गए टाइप के साथ काम करते समय, @DocumentID प्रॉपर्टी जोड़ने की ज़रूरत नहीं होती. जैसे, इस गाइड में दिए गए पिछले उदाहरण में, Book पर टैग का कलेक्शन. नेस्ट की गई प्रॉपर्टी, Cloud Firestore दस्तावेज़ का हिस्सा होती हैं और इनसे कोई अलग दस्तावेज़ नहीं बनता. इसलिए, उन्हें दस्तावेज़ आईडी की ज़रूरत नहीं होती.
तारीख और समय
Cloud Firestore में तारीख और समय को मैनेज करने के लिए, पहले से मौजूद डेटा टाइप होता है. साथ ही, Cloud Firestore में Codable की सुविधा होने की वजह से, इनका इस्तेमाल करना आसान हो जाता है.
आइए, इस दस्तावेज़ पर नज़र डालते हैं. इसमें सभी प्रोग्रामिंग भाषाओं की जननी, एडा के बारे में बताया गया है. इसे 1843 में बनाया गया था:

इस दस्तावेज़ को मैप करने के लिए, Swift टाइप कुछ ऐसा दिख सकता है:
struct ProgrammingLanguage: Codable {
  @DocumentID var id: String?
  var name: String
  var year: Date
}
तारीख और समय के बारे में बात करते हुए, @ServerTimestamp के बारे में बात करना ज़रूरी है. यह प्रॉपर्टी रैपर, आपके ऐप्लिकेशन में टाइमस्टैंप को मैनेज करने के लिए एक बेहतरीन टूल है.
किसी भी डिस्ट्रिब्यूटेड सिस्टम में, ऐसा हो सकता है कि अलग-अलग सिस्टम की घड़ियां हर समय पूरी तरह से सिंक न हों. आपको लग सकता है कि यह कोई बड़ी बात नहीं है. हालांकि, ज़रा सोचिए कि अगर स्टॉक ट्रेड सिस्टम के लिए घड़ी थोड़ी सी भी सिंक नहीं है, तो इसका क्या असर होगा: ट्रेड को पूरा करते समय, एक मिलीसेकंड का अंतर भी लाखों डॉलर का अंतर पैदा कर सकता है.
Cloud Firestore, @ServerTimestamp के तौर पर मार्क किए गए एट्रिब्यूट को इस तरह हैंडल करता है: अगर एट्रिब्यूट को सेव करते समय (उदाहरण के लिए, addDocument() का इस्तेमाल करके) उसकी वैल्यू nil है, तो Cloud Firestore डेटाबेस में लिखते समय, फ़ील्ड में मौजूदा सर्वर टाइमस्टैंप भर देगा. अगर addDocument() या updateData() को कॉल करते समय, फ़ील्ड nil नहीं है, तो Cloud Firestore, एट्रिब्यूट की वैल्यू में कोई बदलाव नहीं करेगा. इस तरह, createdAt और lastUpdatedAt जैसे फ़ील्ड को आसानी से लागू किया जा सकता है.
जियोपॉइंट
हमारे ऐप्लिकेशन में जगह की जानकारी का इस्तेमाल हर जगह किया जाता है. इन्हें सेव करने से, कई शानदार सुविधाएं मिलती हैं. उदाहरण के लिए, किसी टास्क के लिए जगह की जानकारी सेव करना मददगार हो सकता है, ताकि मंज़िल पर पहुंचने पर आपका ऐप्लिकेशन आपको उस टास्क के बारे में याद दिला सके.
Cloud Firestore में पहले से मौजूद डेटा टाइप, GeoPoint होता है. इसमें किसी भी जगह का देशांतर और अक्षांश सेव किया जा सकता है. Cloud Firestore दस्तावेज़ से/में जगहों को मैप करने के लिए, हम GeoPoint टाइप का इस्तेमाल कर सकते हैं:
struct Office: Codable {
  @DocumentID var id: String?
  var name: String
  var location: GeoPoint
}
Swift में इससे मिलता-जुलता टाइप CLLocationCoordinate2D है. हम इन दोनों टाइप के बीच, इस कार्रवाई की मदद से मैप कर सकते हैं:
CLLocationCoordinate2D(latitude: office.location.latitude,
                      longitude: office.location.longitude)
जगह की जानकारी के हिसाब से दस्तावेज़ों के बारे में क्वेरी करने के बारे में ज़्यादा जानने के लिए, यह गाइड देखें.
एनम्स
Swift में, enum शायद सबसे कम आंकी जाने वाली सुविधाओं में से एक है.
हालांकि, यह सुविधा जितनी दिखती है उससे कहीं ज़्यादा काम की है. enum का इस्तेमाल आम तौर पर, किसी चीज़ की अलग-अलग स्थितियों को मॉडल करने के लिए किया जाता है. उदाहरण के लिए, हो सकता है कि हम लेखों को मैनेज करने के लिए कोई ऐप्लिकेशन बना रहे हों. किसी लेख की स्थिति को ट्रैक करने के लिए, हम enum Status का इस्तेमाल कर सकते हैं:
enum Status: String, Codable {
  case draft
  case inReview
  case approved
  case published
}
Cloud Firestore में enum का इस्तेमाल नहीं किया जा सकता.इसका मतलब है कि यह वैल्यू के सेट को लागू नहीं कर सकता. हालांकि, हम अब भी इस बात का फ़ायदा ले सकते हैं कि enum को टाइप किया जा सकता है और कोड किया जा सकने वाला टाइप चुना जा सकता है. इस उदाहरण में, हमने String को चुना है. इसका मतलब है कि Cloud Firestore दस्तावेज़ में स्टोर किए जाने पर, सभी enum वैल्यू को स्ट्रिंग में/से मैप किया जाएगा.
Swift में कस्टम रॉ वैल्यू इस्तेमाल की जा सकती हैं. इसलिए, हम यह भी तय कर सकते हैं कि कौनसी वैल्यू किस enum केस को रेफ़र करेगी. उदाहरण के लिए, अगर हम Status.inReview केस को "समीक्षा में है" के तौर पर सेव करने का फ़ैसला लेते हैं, तो हम ऊपर दिए गए enum को इस तरह अपडेट कर सकते हैं:
enum Status: String, Codable {
  case draft
  case inReview = "in review"
  case approved
  case published
}
मैपिंग को पसंद के मुताबिक बनाना
कभी-कभी, जिन Cloud Firestore दस्तावेज़ों को हमें मैप करना होता है उनके एट्रिब्यूट के नाम, Swift में हमारे डेटा मॉडल की प्रॉपर्टी के नामों से मैच नहीं होते. उदाहरण के लिए, हो सकता है कि हमारे साथ काम करने वाला कोई व्यक्ति Python डेवलपर हो और उसने अपने सभी एट्रिब्यूट के नामों के लिए snake_case को चुना हो.
चिंता न करें: Codable हमारी मदद करता है!
ऐसे मामलों में, हम CodingKeys का इस्तेमाल कर सकते हैं. यह एक enum है, जिसे हम कोडेबल स्ट्रक्चर में जोड़ सकते हैं. इससे यह तय किया जा सकता है कि कुछ एट्रिब्यूट को कैसे मैप किया जाएगा.
इस दस्तावेज़ को देखें:

इस दस्तावेज़ को ऐसे स्ट्रक्चर से मैप करने के लिए जिसमें String टाइप की नेम प्रॉपर्टी हो, हमें ProgrammingLanguage स्ट्रक्चर में CodingKeys एनम जोड़ना होगा. साथ ही, दस्तावेज़ में एट्रिब्यूट का नाम बताना होगा:
struct ProgrammingLanguage: Codable {
  @DocumentID var id: String?
  var name: String
  var year: Date

  enum CodingKeys: String, CodingKey {
    case id
    case name = "language_name"
    case year
  }
}
डिफ़ॉल्ट रूप से, Codable API हमारे Swift टाइप की प्रॉपर्टी के नामों का इस्तेमाल करके, उन Cloud Firestore दस्तावेज़ों पर एट्रिब्यूट के नाम तय करेगा जिन्हें हम मैप करने की कोशिश कर रहे हैं. इसलिए, जब तक एट्रिब्यूट के नाम मैच होते हैं, तब तक हमारे कोड किए जा सकने वाले टाइप में CodingKeys को जोड़ने की ज़रूरत नहीं है. हालांकि, किसी खास टाइप के लिए CodingKeys का इस्तेमाल करने के बाद, हमें उन सभी प्रॉपर्टी के नाम जोड़ने होंगे जिन्हें हमें मैप करना है.
ऊपर दिए गए कोड स्निपेट में, हमने एक id प्रॉपर्टी तय की है. इसका इस्तेमाल, SwiftUI List व्यू में आइडेंटिफ़ायर के तौर पर किया जा सकता है. अगर हम इसे CodingKeys में नहीं बताते, तो डेटा फ़ेच करते समय इसे मैप नहीं किया जाता. इस वजह से, यह nil हो जाता.
इससे List व्यू में पहला दस्तावेज़ भर जाएगा.
मैपिंग की प्रोसेस के दौरान, ऐसी किसी भी प्रॉपर्टी को अनदेखा कर दिया जाएगा जो संबंधित CodingKeys enum में केस के तौर पर शामिल नहीं है. यह तब काफ़ी सुविधाजनक हो सकता है, जब हमें कुछ प्रॉपर्टी को मैप करने से बाहर रखना हो.
उदाहरण के लिए, अगर हमें reasonWhyILoveThis प्रॉपर्टी को मैप होने से रोकना है, तो हमें उसे CodingKeys enum से हटाना होगा:
struct ProgrammingLanguage: Identifiable, Codable {
  @DocumentID var id: String?
  var name: String
  var year: Date
  var reasonWhyILoveThis: String = ""

  enum CodingKeys: String, CodingKey {
    case id
    case name = "language_name"
    case year
  }
}
कभी-कभी, हम Cloud Firestore दस्तावेज़ में खाली एट्रिब्यूट को फिर से लिखना चाहते हैं. Swift में, वैल्यू मौजूद न होने पर, वैकल्पिक वैल्यू का इस्तेमाल किया जाता है. साथ ही, Cloud Firestore में null वैल्यू भी इस्तेमाल की जा सकती हैं.
हालांकि, nil वैल्यू वाले वैकल्पिक फ़ील्ड को एन्कोड करने का डिफ़ॉल्ट तरीका यह है कि उन्हें छोड़ दिया जाए. @ExplicitNull से हमें कुछ हद तक यह कंट्रोल करने की सुविधा मिलती है कि Swift के वैकल्पिक टाइप को एन्कोड करते समय उन्हें कैसे मैनेज किया जाए: किसी वैकल्पिक प्रॉपर्टी को @ExplicitNull के तौर पर फ़्लैग करके, हम Cloud Firestore को बता सकते हैं कि अगर इस प्रॉपर्टी में nil की वैल्यू है, तो इसे दस्तावेज़ में शून्य वैल्यू के साथ लिखें.
रंगों को मैप करने के लिए, कस्टम एन्कोडर और डिकोडर का इस्तेमाल करना
Codable की मदद से डेटा को मैप करने के बारे में, यह हमारा आखिरी विषय है. चलिए, कस्टम एन्कोडर और डिकोडर के बारे में जानते हैं. इस सेक्शन में नेटिव Cloud Firestore डेटा टाइप के बारे में नहीं बताया गया है. हालांकि, कस्टम एन्कोडर और डिकोडर आपके Cloud Firestore ऐप्लिकेशन में काफ़ी काम आते हैं.
"मैं रंगों को कैसे मैप करूं", डेवलपर के सबसे ज़्यादा पूछे जाने वाले सवालों में से एक है. यह सवाल सिर्फ़ Cloud Firestore के लिए नहीं, बल्कि Swift और JSON के बीच मैपिंग के लिए भी पूछा जाता है. इसके लिए कई समाधान उपलब्ध हैं. हालांकि, इनमें से ज़्यादातर JSON पर फ़ोकस करते हैं. साथ ही, इनमें से ज़्यादातर समाधान, रंगों को नेस्ट की गई डिक्शनरी के तौर पर मैप करते हैं. यह डिक्शनरी, आरजीबी कॉम्पोनेंट से बनी होती है.
ऐसा लगता है कि इसके लिए कोई बेहतर और आसान तरीका होना चाहिए. हम वेब कलर का इस्तेमाल क्यों नहीं करते? (या, ज़्यादा सटीक तौर पर, सीएसएस रंग का हेक्स कोड नोटेशन) — इन्हें इस्तेमाल करना आसान है (ज़रूरी तौर पर सिर्फ़ एक स्ट्रिंग) और ये पारदर्शिता के साथ भी काम करते हैं!
Swift Color को उसकी हेक्स वैल्यू से मैप करने के लिए, हमें एक Swift एक्सटेंशन बनाना होगा, जो Color में Codable को जोड़ता है.
extension Color {

 init(hex: String) {
    let rgba = hex.toRGBA()

    self.init(.sRGB,
              red: Double(rgba.r),
              green: Double(rgba.g),
              blue: Double(rgba.b),
              opacity: Double(rgba.alpha))
    }

    //... (code for translating between hex and RGBA omitted for brevity)

}

extension Color: Codable {

  public init(from decoder: Decoder) throws {
    let container = try decoder.singleValueContainer()
    let hex = try container.decode(String.self)

    self.init(hex: hex)
  }

  public func encode(to encoder: Encoder) throws {
    var container = encoder.singleValueContainer()
    try container.encode(toHex)
  }

}
decoder.singleValueContainer() का इस्तेमाल करके, हम String को उसके Color के बराबर डिकोड कर सकते हैं. इसके लिए, हमें आरजीबीए कॉम्पोनेंट को नेस्ट करने की ज़रूरत नहीं है. इसके अलावा, इन वैल्यू को पहले कन्वर्ट किए बिना, अपने ऐप्लिकेशन के वेब यूज़र इंटरफ़ेस (यूआई) में इस्तेमाल किया जा सकता है!
इससे हम टैग को मैप करने के लिए कोड को अपडेट कर सकते हैं. इससे टैग के रंगों को सीधे तौर पर मैनेज करना आसान हो जाता है. इसके लिए, हमें अपने ऐप्लिकेशन के यूज़र इंटरफ़ेस (यूआई) कोड में उन्हें मैन्युअल तरीके से मैप करने की ज़रूरत नहीं पड़ती:
struct Tag: Codable, Hashable {
  var title: String
  var color: Color
}

struct BookWithTags: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var tags: [Tag]
}
गड़बड़ियां ठीक करना
ऊपर दिए गए कोड स्निपेट में, हमने गड़बड़ी को ठीक करने की प्रोसेस को जान-बूझकर कम से कम रखा है. हालांकि, प्रोडक्शन ऐप्लिकेशन में, आपको यह पक्का करना होगा कि किसी भी गड़बड़ी को ठीक से मैनेज किया जाए.
यहां एक कोड स्निपेट दिया गया है. इसमें बताया गया है कि गड़बड़ी की किसी भी स्थिति को कैसे मैनेज किया जा सकता है:
class MappingSimpleTypesViewModel: ObservableObject {
  @Published var book: Book = .empty
  @Published var errorMessage: String?

  private var db = Firestore.firestore()

  func fetchAndMap() {
    fetchBook(documentId: "hitchhiker")
  }

  func fetchAndMapNonExisting() {
    fetchBook(documentId: "does-not-exist")
  }

  func fetchAndTryMappingInvalidData() {
    fetchBook(documentId: "invalid-data")
  }

  private func fetchBook(documentId: String) {
    let docRef = db.collection("books").document(documentId)

    docRef.getDocument(as: Book.self) { result in
      switch result {
      case .success(let book):
        // A Book value was successfully initialized from the DocumentSnapshot.
        self.book = book
        self.errorMessage = nil
      case .failure(let error):
        // A Book value could not be initialized from the DocumentSnapshot.
        switch error {
        case DecodingError.typeMismatch(_, let context):
          self.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
        case DecodingError.valueNotFound(_, let context):
          self.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
        case DecodingError.keyNotFound(_, let context):
          self.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
        case DecodingError.dataCorrupted(let key):
          self.errorMessage = "\(error.localizedDescription): \(key)"
        default:
          self.errorMessage = "Error decoding document: \(error.localizedDescription)"
        }
      }
    }
  }
}
लाइव अपडेट में गड़बड़ियां ठीक करना
पिछले कोड स्निपेट में, किसी एक दस्तावेज़ को फ़ेच करते समय होने वाली गड़बड़ियों को ठीक करने का तरीका बताया गया है. Cloud Firestore, एक बार डेटा फ़ेच करने के अलावा, आपके ऐप्लिकेशन में अपडेट होने पर उन्हें डिलीवर करने की सुविधा भी देता है. इसके लिए, स्नैपशॉट लिसनर का इस्तेमाल किया जाता है: हम किसी कलेक्शन (या क्वेरी) पर स्नैपशॉट लिसनर को रजिस्टर कर सकते हैं. साथ ही, जब भी कोई अपडेट होगा, तब Cloud Firestore हमारे लिसनर को कॉल करेगा.
यहां एक कोड स्निपेट दिया गया है. इसमें स्नैपशॉट लिसनर को रजिस्टर करने, Codable का इस्तेमाल करके डेटा मैप करने, और होने वाली किसी भी गड़बड़ी को ठीक करने का तरीका बताया गया है. इसमें कलेक्शन में नया दस्तावेज़ जोड़ने का तरीका भी बताया गया है. जैसा कि आप देखेंगे, मैप किए गए दस्तावेज़ों को रखने वाले लोकल ऐरे को अपडेट करने की ज़रूरत नहीं है. ऐसा इसलिए, क्योंकि स्नैपशॉट लिसनर में मौजूद कोड इसका ध्यान रखता है.
class MappingColorsViewModel: ObservableObject {
  @Published var colorEntries = [ColorEntry]()
  @Published var newColor = ColorEntry.empty
  @Published var errorMessage: String?

  private var db = Firestore.firestore()
  private var listenerRegistration: ListenerRegistration?

  public func unsubscribe() {
    if listenerRegistration != nil {
      listenerRegistration?.remove()
      listenerRegistration = nil
    }
  }

  func subscribe() {
    if listenerRegistration == nil {
      listenerRegistration = db.collection("colors")
        .addSnapshotListener { [weak self] (querySnapshot, error) in
          guard let documents = querySnapshot?.documents else {
            self?.errorMessage = "No documents in 'colors' collection"
            return
          }

          self?.colorEntries = documents.compactMap { queryDocumentSnapshot in
            let result = Result { try queryDocumentSnapshot.data(as: ColorEntry.self) }

            switch result {
            case .success(let colorEntry):
              if let colorEntry = colorEntry {
                // A ColorEntry value was successfully initialized from the DocumentSnapshot.
                self?.errorMessage = nil
                return colorEntry
              }
              else {
                // A nil value was successfully initialized from the DocumentSnapshot,
                // or the DocumentSnapshot was nil.
                self?.errorMessage = "Document doesn't exist."
                return nil
              }
            case .failure(let error):
              // A ColorEntry value could not be initialized from the DocumentSnapshot.
              switch error {
              case DecodingError.typeMismatch(_, let context):
                self?.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
              case DecodingError.valueNotFound(_, let context):
                self?.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
              case DecodingError.keyNotFound(_, let context):
                self?.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
              case DecodingError.dataCorrupted(let key):
                self?.errorMessage = "\(error.localizedDescription): \(key)"
              default:
                self?.errorMessage = "Error decoding document: \(error.localizedDescription)"
              }
              return nil
            }
          }
        }
    }
  }

  func addColorEntry() {
    let collectionRef = db.collection("colors")
    do {
      let newDocReference = try collectionRef.addDocument(from: newColor)
      print("ColorEntry stored with new document reference: \(newDocReference)")
    }
    catch {
      print(error)
    }
  }
}
इस पोस्ट में इस्तेमाल किए गए सभी कोड स्निपेट, एक सैंपल ऐप्लिकेशन का हिस्सा हैं. इसे इस GitHub रिपॉज़िटरी से डाउनलोड किया जा सकता है.
Codable का इस्तेमाल करें!
Swift का Codable API, डेटा को सीरियलाइज़ किए गए फ़ॉर्मैट से आपके ऐप्लिकेशन के डेटा मॉडल में और डेटा मॉडल से सीरियलाइज़ किए गए फ़ॉर्मैट में मैप करने का एक बेहतर और आसान तरीका उपलब्ध कराता है. इस गाइड में, आपने देखा कि Cloud Firestore को डेटास्टोर के तौर पर इस्तेमाल करने वाले ऐप्लिकेशन में, इसे इस्तेमाल करना कितना आसान है.
हमने आसान डेटा टाइप वाले एक बुनियादी उदाहरण से शुरुआत की. इसके बाद, हमने डेटा मॉडल की जटिलता को धीरे-धीरे बढ़ाया. इस दौरान, हम Codable और Firebase के लागू करने के तरीके पर भरोसा कर पाए, ताकि हमारे लिए मैपिंग की जा सके.
Codable के बारे में ज़्यादा जानने के लिए, हमारा सुझाव है कि आप ये लेख पढ़ें:
- जॉन संडेल ने Codable की बुनियादी बातों के बारे में एक अच्छा लेख लिखा है.
- अगर आपको किताबें पढ़ना पसंद है, तो मैट की फ़्लाइट स्कूल गाइड टू स्विफ़्ट कोडेबल पढ़ें.
- आखिर में, डॉनी वॉल्स के पास Codable के बारे में पूरी सीरीज़ है.
हमने Cloud Firestore दस्तावेज़ों को मैप करने के लिए, एक पूरी गाइड तैयार करने की पूरी कोशिश की है. हालांकि, यह पूरी नहीं है. ऐसा हो सकता है कि आप अपने टाइप को मैप करने के लिए, अन्य रणनीतियों का इस्तेमाल कर रहे हों. नीचे दिए गए सुझाव/राय दें या शिकायत करें बटन का इस्तेमाल करके, हमें बताएं कि अन्य तरह के Cloud Firestore डेटा को मैप करने या Swift में डेटा दिखाने के लिए, कौनसी रणनीतियां इस्तेमाल की जाती हैं.
Cloud Firestore के Codable सपोर्ट का इस्तेमाल न करने की कोई वजह नहीं है.